视觉配准
本页是森林火灾 VIS–IR 配准的统一主笔记:预处理、坐标、主流程、实验协议和阶段记录集中在这里。局部特征、强度一致性、深度特征等方法仍保留独立笔记,避免把不同假设和实验结论混成一个算法。
配准总览:预处理与增强策略
1. 预处理候选及取舍
预处理的目标是建立可比较的公共视场,而不是为了让图像看起来更“满”。当前候选策略如下:
| 策略 | 做法 | 主要风险 | 当前定位 |
|---|---|---|---|
| VIS 固定底板 | 将完整 IR 依据标定 footprint 映射到 VIS,再共同裁剪并缩放 | 旧流程中的零填充会丢边缘信息 | 已被正式流程替代;仅作历史对照 |
| IR 保留优先 | 完整 IR 先参与标定,再生成公共视场 | 需要固定裁剪框并处理越界 | 当前正式流程,详见正式坐标协议 |
| 梯度/边缘辅助 | 从 VIS、IR 或白热图中提取梯度,只把辅助图用于匹配或质量检查 | 边缘增强不能替代几何标定;过度增强会放大噪声 | 作为可消融的输入分支,不改原图坐标 |
“白热图像就是可见光二值化”的说法不准确:白热 JPEG 通常是热成像设备对辐射数据做了自动增益、灰度或伪彩映射,并非 VIS 的二值化结果。因此它可以提供边缘/梯度线索,但不能直接当作可见光真值。若需要二次裁剪,裁剪框必须由标定 footprint 和固定统计规则确定;不能对每一对图重新找公共交集,否则会改变样本坐标系并引入不可复现的偏移。
正式尺寸链只有一条:原始 VIS 1920×1080、完整 IR 640×512 → 标定 footprint 的 1218×975 → 两幅图共同裁取 1216×912 → 等比例缩放至 640×480。精配准时只移动 IR,VIS 不再裁剪或回算。
2. 配准前的增强分支(保持可消融)
传统讨论中提出两条互补思路:
- 卷积/滤波增强:在匹配前对两模态分别计算 Sobel、LoG 或轻量卷积特征,突出稳定边缘,再将增强图送入匹配器。增强只作用于匹配输入,不改变原始像素和坐标;卷积核类型、强度和是否使用应作为消融变量。
- 边缘框/边缘强化:以边缘响应或 EdgeBoxes 一类候选区域为引导,优先在结构明显的区域估计变换。它适合纹理稀疏、跨模态亮度差异大的场景,但必须配合 RANSAC、几何范围检查和失败回退,不能把边缘候选直接当作最终矩阵。
这两条分支与主流程的关系是“输入增强 → 独立配准器 → 统一评价”,不是再拆成两份笔记。方法族的完整说明见:几何匹配:局部特征、卷积与 RANSAC、强度一致性匹配、深度匹配与 LM²R-Net 候选框架。实验参数和结果统一汇总在配准实验与工程验证,论文叙事与阶段记录见配准总览与研究叙事。
配准教程入口:从输入到验收
目标与适用场景
目标是在森林火灾等跨模态场景中,将同一时刻的可见光(VIS)与长波红外(IR)图像映射到同一 640×480 工作坐标系,减少火区、人员和背景结构的重影,为后续融合、检测和端侧部署提供稳定输入。本流程适用于相机内外参基本固定、两模态视场存在差异但有重叠区域的双光设备;不适用于没有共同视场、时间不同步严重或只有单模态图像的样本。
输入与前置检查
| 项目 | 要求 |
|---|---|
| VIS 原图 | 1920×1080,保留原始文件 |
| IR 原图 | 640×512,不能先擅自裁掉上下边 |
| 标定信息 | 双模态标定板对应点、初始变换或距离查表 |
| 工作画布 | 固定为 640×480;VIS 是固定底板 |
| 质量记录 | 保存变换矩阵、有效 Mask、失败原因和评价指标 |
运行前先检查图像尺寸、通道、文件配对和标定矩阵方向;任何一项不满足都先修复输入,不要用“重新裁剪到看起来对齐”掩盖坐标错误。
统一步骤
- 建立初始几何关系:用双模态标定板或已验证的距离查表得到初始变换,将完整 IR 映射到 VIS 坐标系。
- 生成固定公共视场:依据 IR footprint 对 VIS、IR 与 Mask 做第一次统一裁剪,再共同裁取 4∶3 区域并等比例缩放到 640×480。
- 粗配准/候选生成:按当前实验配置运行 XoFTR、局部特征或其他独立方法,使用 RANSAC 和几何范围检查排除明显错配;不同方法的结果分别记录,不能互相覆盖。
- 精配准:在固定 640×480 画布中只移动 IR。语义区域可用于 ECC 或残差搜索的评价,但不得移动 VIS 或改变公共坐标系。
- 质量门控与回退:同时检查 MI/NMI、EdgeF1、Chamfer、语义区域一致性、黑边比例和变换范围;任一指标越界则记录失败并回退到上一级可信结果。
- 输出与审计:直接输出 640×480 的 registered、overlay、checkerboard、Mask 和 metrics;保留每对图的矩阵与参数,保证能够复现和定位失败。
参数、验证与失败边界
- 正式坐标口径、裁剪框和 IR-only 规则以本页正式坐标协议为准;不要沿用旧的“每对重新取公共交集”或“IR 上下各裁 16 像素”口径。
- 评价至少包含几何误差(landmark RMSE 或 Chamfer)、边缘对齐(EdgeF1)、跨模态统计一致性(MI/NMI)和运行效率(平均耗时、T95/FPS)。只看 ECC 相关系数或肉眼 overlay 不能证明配准可用。
- 纹理太少、火焰/烟雾遮挡、时间不同步、初始平移超出搜索范围、Mask 为空或 IR 越界过多时,算法可能失败。应输出明确失败原因和回退层级,不得静默接受异常矩阵。
结论与独立方法边界
主流程负责定义统一输入、坐标和验收规则;局部特征匹配、强度一致性匹配、深度匹配、融合羽化和真值驱动实操各自回答不同问题,因此继续保持独立笔记。它们可以在第 3 步作为候选方法接入,但最终都必须在同一 640×480 坐标和同一指标集上比较。
正式坐标协议:完整尺寸链与 IR-only 精配准
本节已吸收“配准算法预处理:第一次标定裁剪、640×480 固定画布与 IR-only 精配准”的完整正式版本;原页面已并入并删除,后续只维护本节。
原始输入为 VIS 1920×1080 和完整 IR 640×512。先按标定参数放大、移动完整 IR,并依据标定后 IR footprint 对 VIS、IR 与几何 Mask 统一完成第一次裁剪,当前中间画布为 1218×975。由于算法输入固定为 640×480,再对 VIS 与 IR 使用同一个居中 4∶3 裁剪框,当前为 (x=1,y=31,w=1216,h=912),然后共同等比例缩放为 640×480。自动精配准直接在此 640×480 固定画布内进行,只移动 IR:越界 IR 被截去,未覆盖区域补黑;VIS 不再裁剪、移动、缩放或补边。最终结果直接输出 640×480,不反算回 1218×975 或原始坐标。
第二次精配准后的“裁剪”仅指 IR 移动后超出 640×480 固定画布的部分被截断。不得根据每对图像重新计算 VIS/IR 公共交集,不得再次裁 VIS,也不得为了消除 IR 黑边而改变 VIS。IR 黑边表示该区域没有热红外覆盖,对应 VIS 像素仍然有效并必须保留。
1. 三层坐标与尺寸
原始层:
VIS_raw = 1920×1080
IR_raw  = 640×512(完整保留)

第一次标定裁剪中间层:
VIS_1 / IR_1 / MASK_1 = 1218×975

正式算法与输出层:
共同裁出 1216×912 → 共同等比例缩放 → 640×480
VIS_640 / IR_640 / MASK_640 = 640×480
必须区分:
1218×975是完成标定映射后的第一次裁剪中间画布;640×480是算法精配准的固定工作画布,也是正式输出画布;640×480不是旧的 VIS/IR 独立 letterbox,也不是分别独立裁剪;- 精配准结果不恢复到
1218×975,直接在640×480输出。
2. 原始输入与标定
输入固定为:
VIS_raw:1920×1080
IR_raw: 640×512
要求:
- 完整保留 IR 640×512,不固定裁除上下各 16 像素;
- 不根据黑色像素值判断 IR 几何有效区;
- IR 有效支撑由全 1 Mask 经过相同几何变换得到;
- 标定矩阵方向固定为 IR 原始坐标 → VIS 原始坐标。
标定矩阵:
[ H_{\mathrm{cal}}= \begin{bmatrix} s&0&dx\ 0&s&dy\ 0&0&1 \end{bmatrix}. ]
当前六对手工标定使用固定尺度 s=1.902,近、中、远距离档使用各自稳健 dx、dy。
3. 第一次裁剪:完整 IR footprint
先把完整 IR 与全 1 Mask 映射到 VIS 原始画布:
IR_cal_raw     = Warp(IR_raw, H_cal, VIS_canvas=1920×1080)
IR_support_raw = Warp(ones(640×512), H_cal, VIS_canvas=1920×1080)
理论 footprint 尺寸为:
s×640 × s×512 = 1217.28 × 973.824
采用确定性整数包围规则后,当前共享第一次裁剪尺寸为:
CROP1_W × CROP1_H = 1218 × 975
当前各距离档第一次裁剪框:
near:(387, 59, 1218, 975)
mid: (403, 77, 1218, 975)
far: (387, 79, 1218, 975)
第一次裁剪同时作用于:
VIS_1  = Crop(VIS_raw, CROP1)
IR_1   = Warp/Crop(IR_raw, H_cal, CROP1)
MASK_1 = Warp/Crop(ones(640×512), H_cal, CROP1)
输出均为 1218×975。这一层只负责完成标定后的同视场统一裁剪。
4. 共同生成正式 640×480 画布
算法硬性输入为 640×480,因此在第一次裁剪后,对 VIS_1、IR_1、MASK_1 使用完全相同的 4∶3 裁剪:
CROP2 = (x=1, y=31, w=1216, h=912)
然后共同等比例缩放:
1216×912 → 640×480
缩放比例 = 640/1216 = 480/912
生成:
VIS_640  = Resize(Crop(VIS_1, CROP2), 640×480)
IR_640   = Resize(Crop(IR_1, CROP2), 640×480)
MASK_640 = Resize(Crop(MASK_1, CROP2), 640×480)
Mask 使用最近邻插值,图像使用一致的图像插值规则。VIS 与 IR 必须使用同一 CROP2 和同一等比例缩放;不得各自独立中心裁剪、独立 letterbox 或非等比例拉伸。640×480 是正式算法输入与最终输出,不是临时网络副本。
5. 第二次精配准:固定 640×480 中只移动 IR
自动算法直接在 VIS_640、IR_640 上估计 IR→VIS 的精配准矩阵 H_fine_640。
正式输出:
VIS_final  = VIS_640
IR_final   = Warp(IR_640, H_fine_640,
                  canvas=(640,480), border=black)
MASK_final = Warp(MASK_640, H_fine_640,
                  canvas=(640,480), border=0)
严格规则:VIS_final 必须逐像素等于 VIS_640;只允许 IR 和 IR Mask 发生精配准变换;IR 越出 640×480 固定画布的部分被截断;未覆盖区域补黑,Mask 对应区域补 0;不重新裁剪 VIS、不按每张图的精配准位移求新的公共交集、不反算回 1218×975 或 1920×1080。最终 overlay、融合输入、注册图和 Mask 均为 640×480。
多张图像的精配准位移必然不同,因此 IR 黑边宽度可以随样本变化;VIS 画布和输出尺寸始终固定。
6. 最终坐标关系
设 C_1 为原始 VIS 到第一次裁剪坐标的平移,B 为第一次裁剪画布到最终 640×480 的共同裁剪与缩放,则:
[ H_{\mathrm{pre},640}=B C_1 H_{\mathrm{cal}}. ]
最终 IR 原图到 640×480 输出的复合关系为:
[ H_{\mathrm{final},640}=H_{\mathrm{fine},640} B C_1 H_{\mathrm{cal}}. ]
正式实现可从 IR 原图用最终复合矩阵一次重采样到 640×480,以减少插值累积;H_fine_640 不需要反算到 1218×975 或原始 VIS 坐标。
7. 禁止使用的错误流程
禁止固定裁除 IR 上下各 16 像素;标定前把 VIS 与 IR 分别独立 letterbox;第一次裁剪不覆盖完整 IR footprint;VIS 与 IR 使用不同的第二裁剪框;把 1218×975 非等比例拉伸成 640×480;精配准后重新计算公共交集;为消除 IR 黑边而缩小 VIS;把 IR 黑色像素值当作无效 Mask;把精配准矩阵反算回 1218×975 后作为正式输出。
8. 实现检查表
- 原始 VIS 为 1920×1080,原始 IR 为完整 640×512;
- 使用正确距离档的
scale、dx、dy; - 第一次裁剪来自完整 IR 标定 footprint,并统一为 1218×975;
- VIS_1、IR_1、MASK_1 使用同一第一次裁剪区域;
- 第二个共同裁剪为
(1,31,1216,912),等比例缩放到 640×480; - 精配准矩阵直接定义在 640×480,且只移动 IR;
- IR 越界截断、未覆盖区域补黑,VIS 在精配准阶段逐像素不变;
- 最终输出固定为 640×480,不反算回 1218×975 或原始坐标;
- IR Mask 使用与 IR 完全相同的几何链。
9. 旧数据、VIS 固定底板与标注回查
FF‑VI3083 现存旧实验虽然也是 640×480,但生成过程与本流程不同,不能自动声称按本流程生成。本流程适用于能够确认 1920×1080 VIS、完整 640×512 IR 和标定参数的新数据。
VIS 作为固定底板是因为分辨率更高、视场更宽;IR 的“放大”只是把热信号插值到 VIS 网格,并不创造细节。IR 有效区域必须由完整 IR 的几何支撑 Mask 确定,不能依据亮度或固定裁掉上下 16 像素。
稳定硬件、分辨率和工作模式下,尺度可以由人工真值统计后固化;在线阶段只以 BASE_DX、BASE_DY 为初值做小范围平移微调。物距变化造成的视差首先表现为深度相关的 dx、dy 变化,不等同于尺度漂移;每帧微调应设门限,超限时记录异常并回退或触发重新配准。
若最终 640×480 图来自 VIS 原图中左上角 (x_offset,y_offset)、尺寸 W_crop×H_crop 的区域,LabelMe 点 (x_label,y_label) 回到 VIS 原图为:
X_1920 = x_label × (W_crop ÷ 640) + x_offset
Y_1920 = y_label × (H_crop ÷ 480) + y_offset
这只用于审计和回查标注;正式配准结果不反算,始终直接输出 640×480。
论文计划与实验安排
| **模块** | **当前状态** | **需新增/修改** | **预估工时** |
| Abstract | 需修改 | 重写,强调结构化人工+多指标门控 | 0.5天 |
| 1. 引言 | 需大幅修改 | 新增1.3痛点(人工瓶颈)、重写1.4贡献 | 1天 |
| 2. 相关工作 | 需新增 | 整节新写(人机协同、异构计算) | 1天 |
| 3.1 总体流程 | 已有基础 | 更新流程图,微调文字 | 0.5天 |
| 3.2 两阶段粗配准 | 需重写 | 整小节新写,含两阶段设计依据 | 1天 |
| 3.3 卷积增强 | 需新增 | 整小节新写 | 0.5天 |
| 3.4 ECC精配准 | 已有 | 微调,强调增强输入 | 0.25天 |
| 3.5 多指标门控 | 需新增 | 整小节新写,含三指标定义与阈值依据 | 1天 |
| 3.6 多路兜底与批处理 | 需大幅修改 | 原2.3扩展为三路分支+批处理 | 1天 |
| 3.7 闭环反哺 | 需新增 | 整小节新写 | 0.5天 |
| 3.8 异构并行加速 | 需新增 | 整小节新写 | 0.5天 |
| 3.9 标签迁移 | 已有 | 基本不变 | 0天 |
| 4.1-4.2 配准实验 | 需更新 | 按新方法重新跑数据,更新表格 | 2天 |
| 4.2.3 消融实验 | 需新增 | 设计并执行消融实验,制表 | 1.5天 |
| 4.2.4 操作员一致性 | 需新增 | 设计并执行一致性实验 | 1天 |
| 4.3 计算效率分析 | 需新增 | 画三条曲线,写分析 | 1.5天 |
| 4.4 鲁棒性分析 | 需新增 | 设计扰动实验,画曲线 | 1天 |
| 4.7 闭环反哺实验 | 需新增 | 微调LoFTR+对比实验 | 2天 |
| 5. 讨论 | 需新增 | 整节新写 | 1天 |
| 6. 结论 | 需修改 | 更新局限性与未来工作 | 0.5天 |
| 参考文献 | 需补充 | 新增5-8篇 | 0.5天 |
| 通读润色 | 全文 | 统一术语、检查逻辑、格式调整 | 2天 |
| **实验项目** | **数据需求** | **代码改动** | **预估工时** |
| 两阶段粗配准数据采集 | 需重新标注部分样本以记录两阶段平移量 | 需修改标注工具记录dx1,dy1,dx2,dy2 | 2天 |
| 卷积增强ECC | 在现有数据上重新跑ECC | 新增LoG滤波模块 | 1天 |
| 多指标门控实现 | 全量数据 | MI/Chamfer/梯度互相关等计算模块 | 2天 |
| 三路分支逻辑 | 全量数据 | 修改主流程控制逻辑 | 1天 |
| LoFTR批处理兜底 | 失败子集 | 集成LoFTR+批处理推理 | 2天 |
| CPU-GPU并行优化 | 全流程 | 任务划分+CUDA流优化 | 2天 |
| 消融实验 | 全量数据 | 按配置分别运行并记录 | 1.5天 |
| 操作员一致性实验 | 50对×3人 | 组织3人标注并统计 | 1天 |
| 速度-精度曲线 | 已有各方法耗时数据 | 整理绘图 | 0.5天 |
| 鲁棒性扰动实验 | 抽样100对 | 编写扰动脚本+批量测试 | 1天 |
| 闭环微调实验 | 高质量池样本 | LoFTR微调代码+评测 | 2天 |
| **类别** | **预估工时** | **备注** |
| 论文写作 | 20天 | 含新增章节和全文润色 |
| 实验实施 | 16天 | 含代码开发和数据重跑 |
| 图表绘制 | 4天 | 流程图、曲线图、架构图 |
| 投稿准备 | 2天 | 格式调整、补充材料、投稿信 |
| **合计** | **42天** | 约8-9周(全职)或3-4个月(兼职) |
森林火灾 RGB-红外配准论文:完整实验流程重构
核心定位
这篇论文不能再写成“跑了 B8/B9/B11,然后在 1116 上统计通过率”。新的主线应该是:
原始双光图像为什么不对齐
↓
用双模态标定板建立初配准
↓
用语义区域引导精配准
↓
用 ECC 做逐图微调
↓
用实例级残差修正小目标
↓
用定量、定性、消融、端侧部署证明方法有效
论文要从工程日志改成标准方法论文。1116 只是 FFVI3083 中划分出的最终测试子集,不是额外独立数据集,也不能写成 3083 + 1116。
1. 数据获取与原始问题展示
这一部分回答三个问题:
生图在哪里?
为什么需要配准?
不同设备的 RGB 和红外为什么不能直接叠加?
1.1 原始双光图像采集
数据来源包括多种双光设备或平台:
M300 / Mavic2 / 海康双光 / SC-DM13 / 预二设备
每种设备都要展示一组原始图:
第一列:RGB 原图
第二列:IR 原图
第三列:RGB-IR 直接叠加图
图注要突出三类不一致:
1. 尺度不一致:RGB 分辨率高,红外分辨率低。
2. 视场不一致:两个相机的视角和安装位置不同。
3. 设备偏移规律不一致:有的向左偏,有的向下偏,有的存在尺度拉伸。
这张图的作用是告诉审稿人:原始双光图确实不能直接用于火区和消防员空间关系判断,所以配准是必要步骤。
1.2 数据集口径
正确写法:
FFVI3083 数据集共包含 3083 对 RGB-红外图像。其中一部分用于训练语义检测器、方法开发和参数确定;其中 1116 对作为最终保留测试子集,不参与检测器训练和参数调节,只用于最终推理验证。
不要写:
3083 + 1116
更准确的叫法:
1116 held-out test subset
1116 保留测试子集
最终测试子集
它可以说“独立于训练过程”,但不能说成独立于 FFVI3083 总数据集的外部独立数据集。
2. 初配准准备实验
初配准是整个流程的几何起点,需要明确说明其来源、计算过程与验证方式。 建议写成以下 5 小节:
2.1 双模态标定板设计
2.2 多距离多点拍摄
2.3 对应点提取
2.4 初始变换矩阵或查表生成
2.5 裁剪与统一尺度
2.1 双模态标定板设计
这部分是一个小工作量,必须展现出来。 写法:
本文设计双模态标定板,使同一物理标定点能够同时在可见光图像和红外图像中被检测。标定点由可见光 LED 发光点和红外发热点组成,二者在空间上重叠或保持固定相对位置。RGB 图像中提取 LED 亮点中心,红外图像中提取热源中心,由此形成 RGB-IR 对应点。
需要画标定板示意图:
RGB 视角:LED 亮点
IR 视角:热源亮点
或者画成:
同一标定点
├── 可见光:LED 发光点
└── 红外:发热点
图名:
图 X 双模态标定板结构示意图
图注:
标定点同时包含可见光发光特征和红外热特征,用于建立 RGB 与红外图像之间的对应关系。
2.2 多距离多点拍摄
当前记录使用蒋志在教室采集的图像作为初步样本,并按 1、2、3、4、5 五个距离档位整理;后续补拍森林或室外样本时,应以同一采集规范替换并重新记录结果。
| 距离档位 | 场景类型 | 采集内容 | 作用 |
| A | 近距离 | 标定板 + 室内背景 | 近距离偏移估计 |
| B | 中近距离 | 标定板 + 人员 | 常规偏移估计 |
| C | 中距离 | 标定板 + 复杂背景 | 坐标换算拟合 |
| D | 中远距离 | 标定板 + 小目标 | 小目标偏移验证 |
| E | 远距离 | 室外/森林背景 | 远距离泛化验证 |
| 距离档位 | tx | ty | sx | sy | 初始矩阵 |
| --- | ---: | ---: | ---: | ---: | --- |
| A | 未测量 | 未测量 | 未测量 | 未测量 | HA |
| B | 未测量 | 未测量 | 未测量 | 未测量 | HB |
| C | 未测量 | 未测量 | 未测量 | 未测量 | HC |
| D | 未测量 | 未测量 | 未测量 | 未测量 | HD |
| E | 未测量 | 未测量 | 未测量 | 未测量 | HE |
| 参数 | 设置 |
| 检测模型 | YOLOv8n |
| 预训练权重 | yolov8n.pt(Ultralytics 预训练权重) |
| 输入尺寸 | 960 × 960 |
| Batch size | 8 |
| Epochs | 100 |
| 类别 | fire / firefighter / smoke |
| 训练集 | non1116 train |
| 验证集 | non1116 dev_val |
| 测试集 | 1116 held-out test subset |
| 优化器 | 按 YOLO 默认配置,最终补真实设置 |
| 数据增强 | 按 YOLO 默认配置,最终补真实设置 |
| 项目 | 配置 |
| 操作系统 | Ubuntu / Windows |
| CPU | 未记录 |
| GPU | RTX 5080 / 真实实验 GPU |
| 内存 | 未记录 |
| Python | 未记录 |
| OpenCV | 未记录 |
| PyTorch | 未记录 |
| CUDA | 未记录 |
| 指标类别 | 指标 | 含义 |
| 像素相关 | NCC | 衡量两图相关性 |
| 信息一致性 | MI | 衡量跨模态信息一致性 |
| 优化目标 | ECC | 衡量增强相关系数 |
| 边缘重影 | Grad-NCC / Edge Corr | 衡量边缘是否重合 |
| 语义主体 | fire/person consistency | 衡量火区和人员是否对齐 |
| 效率 | Time / FPS | 衡量部署潜力 |
6.5 论文指标口径
论文表格中的指标统一按下面的口径解释,避免把“指标”和“方法”混在一起:
- Usable registration rate (%):
EdgeF1@3 > 0.3的样本比例,即达到可接受边缘对齐标准的图像对占比。 - Time (s):处理一对图像所需的运行时间,反映方法的效率。
- MI ↑:互信息(Mutual Information)评价值,衡量配准后跨模态图像的统计一致性;这里是评价指标,不是方法名称。
- EdgeF1@3 ↑:3 px 容差内的边缘对齐 F1 分数,综合 precision 与 recall,越高越好;它也是 usable rate 的判定依据。
- Chamfer ↓ (px):两组边缘/轮廓点之间的平均最近距离,越低表示边界越贴合。
- Landmark RMSE:每张图选取 10 个人工对应点,先计算该图的 RMSE,再在 50 张图的 per-image RMSE 分布上报告 Mean、Median 和 P95。计算方式为
RMSE_image = sqrt((1/N) * Σ d_i²), N = 10;P95 是分布统计量,不是另一种 RMSE 算法。该指标用于比较模块能力,不作为 usable/pass-fail 门槛。
论文中的实验组和历史结果仍保留在论文:术语与早期实验设计,当前工程验收统一使用本节口径。
7. 主实验
主实验应按完整流程运行一遍,并保存中间结果与最终指标。 输入:
RGB/IR 原始图像
流程:
初始坐标换算
↓
裁剪统一尺度
↓
语义检测器提取 fire / firefighter / smoke
↓
语义 ROI 构建
↓
语义引导 ECC 精配准
↓
实例级残差校正
↓
有效性判断
主表不要一上来写复杂门控字段,建议这样:
| 方法阶段 | NCC ↑ | MI ↑ | Edge Corr ↑ | fire_ok ↑ | firefighter_ok ↑ | Time/ms ↓ | FPS ↑ |
| --- | ---: | ---: | ---: | ---: | ---: | ---: | ---: |
| 原始未配准 | - | - | |||||
| 初配准 | |||||||
| 语义引导 ECC | |||||||
| 完整方法 |
| 方法 | NCC ↑ | MI ↑ | Edge Corr ↑ | fire_ok ↑ | firefighter_ok ↑ | Time/ms ↓ | FPS ↑ |
| --- | ---: | ---: | ---: | ---: | ---: | ---: | ---: |
| SIFT+RANSAC | |||||||
| ORB+RANSAC | |||||||
| AKAZE+RANSAC | |||||||
| ECC | |||||||
| LoFTR | |||||||
| XoFTR | |||||||
| Ours |
| 配置 | 初配准 | 语义引导 | ECC 精配准 | 实例残差/有效性判断 | NCC ↑ | MI ↑ | Edge Corr ↑ | fire_ok ↑ | firefighter_ok ↑ | FPS ↑ |
| --- | --- | --- | --- | --- | ---: | ---: | ---: | ---: | ---: | ---: |
| 原始未配准 | × | × | × | × | - | |||||
| w/o 初配准 | × | √ | √ | √ | ||||||
| w/o 语义引导 | √ | × | √ | √ | ||||||
| w/o ECC | √ | √ | × | √ | ||||||
| w/o 实例残差 | √ | √ | √ | × | ||||||
| Ours | √ | √ | √ | √ |
| 平台 | 输入尺寸 | 平均时间/ms | FPS | 内存占用 | 说明 |
| --- | ---: | ---: | ---: | ---: | --- |
| RTX 工作站 | 主实验平台 | ||||
| RDK X5 / RK 板 | 端侧测试 | ||||
| CPU only | 低算力参考 |
15. 阶段运行记录:2026-05-23
15.1 环境自检
在 5080 工作站运行实验前,先确认关键依赖可导入;其中 PyTorch 版本和 CUDA 状态使用合法属性名读取:
python -c "import cv2; print('cv2 ok')"
python -c "import matplotlib._path; print('matplotlib ok')"
python -c "import pandas; print('pandas ok')"
python -c "import pytorch_lightning; print('pl ok')"
python -c "import torch; print(torch.__version__, torch.cuda.is_available())"
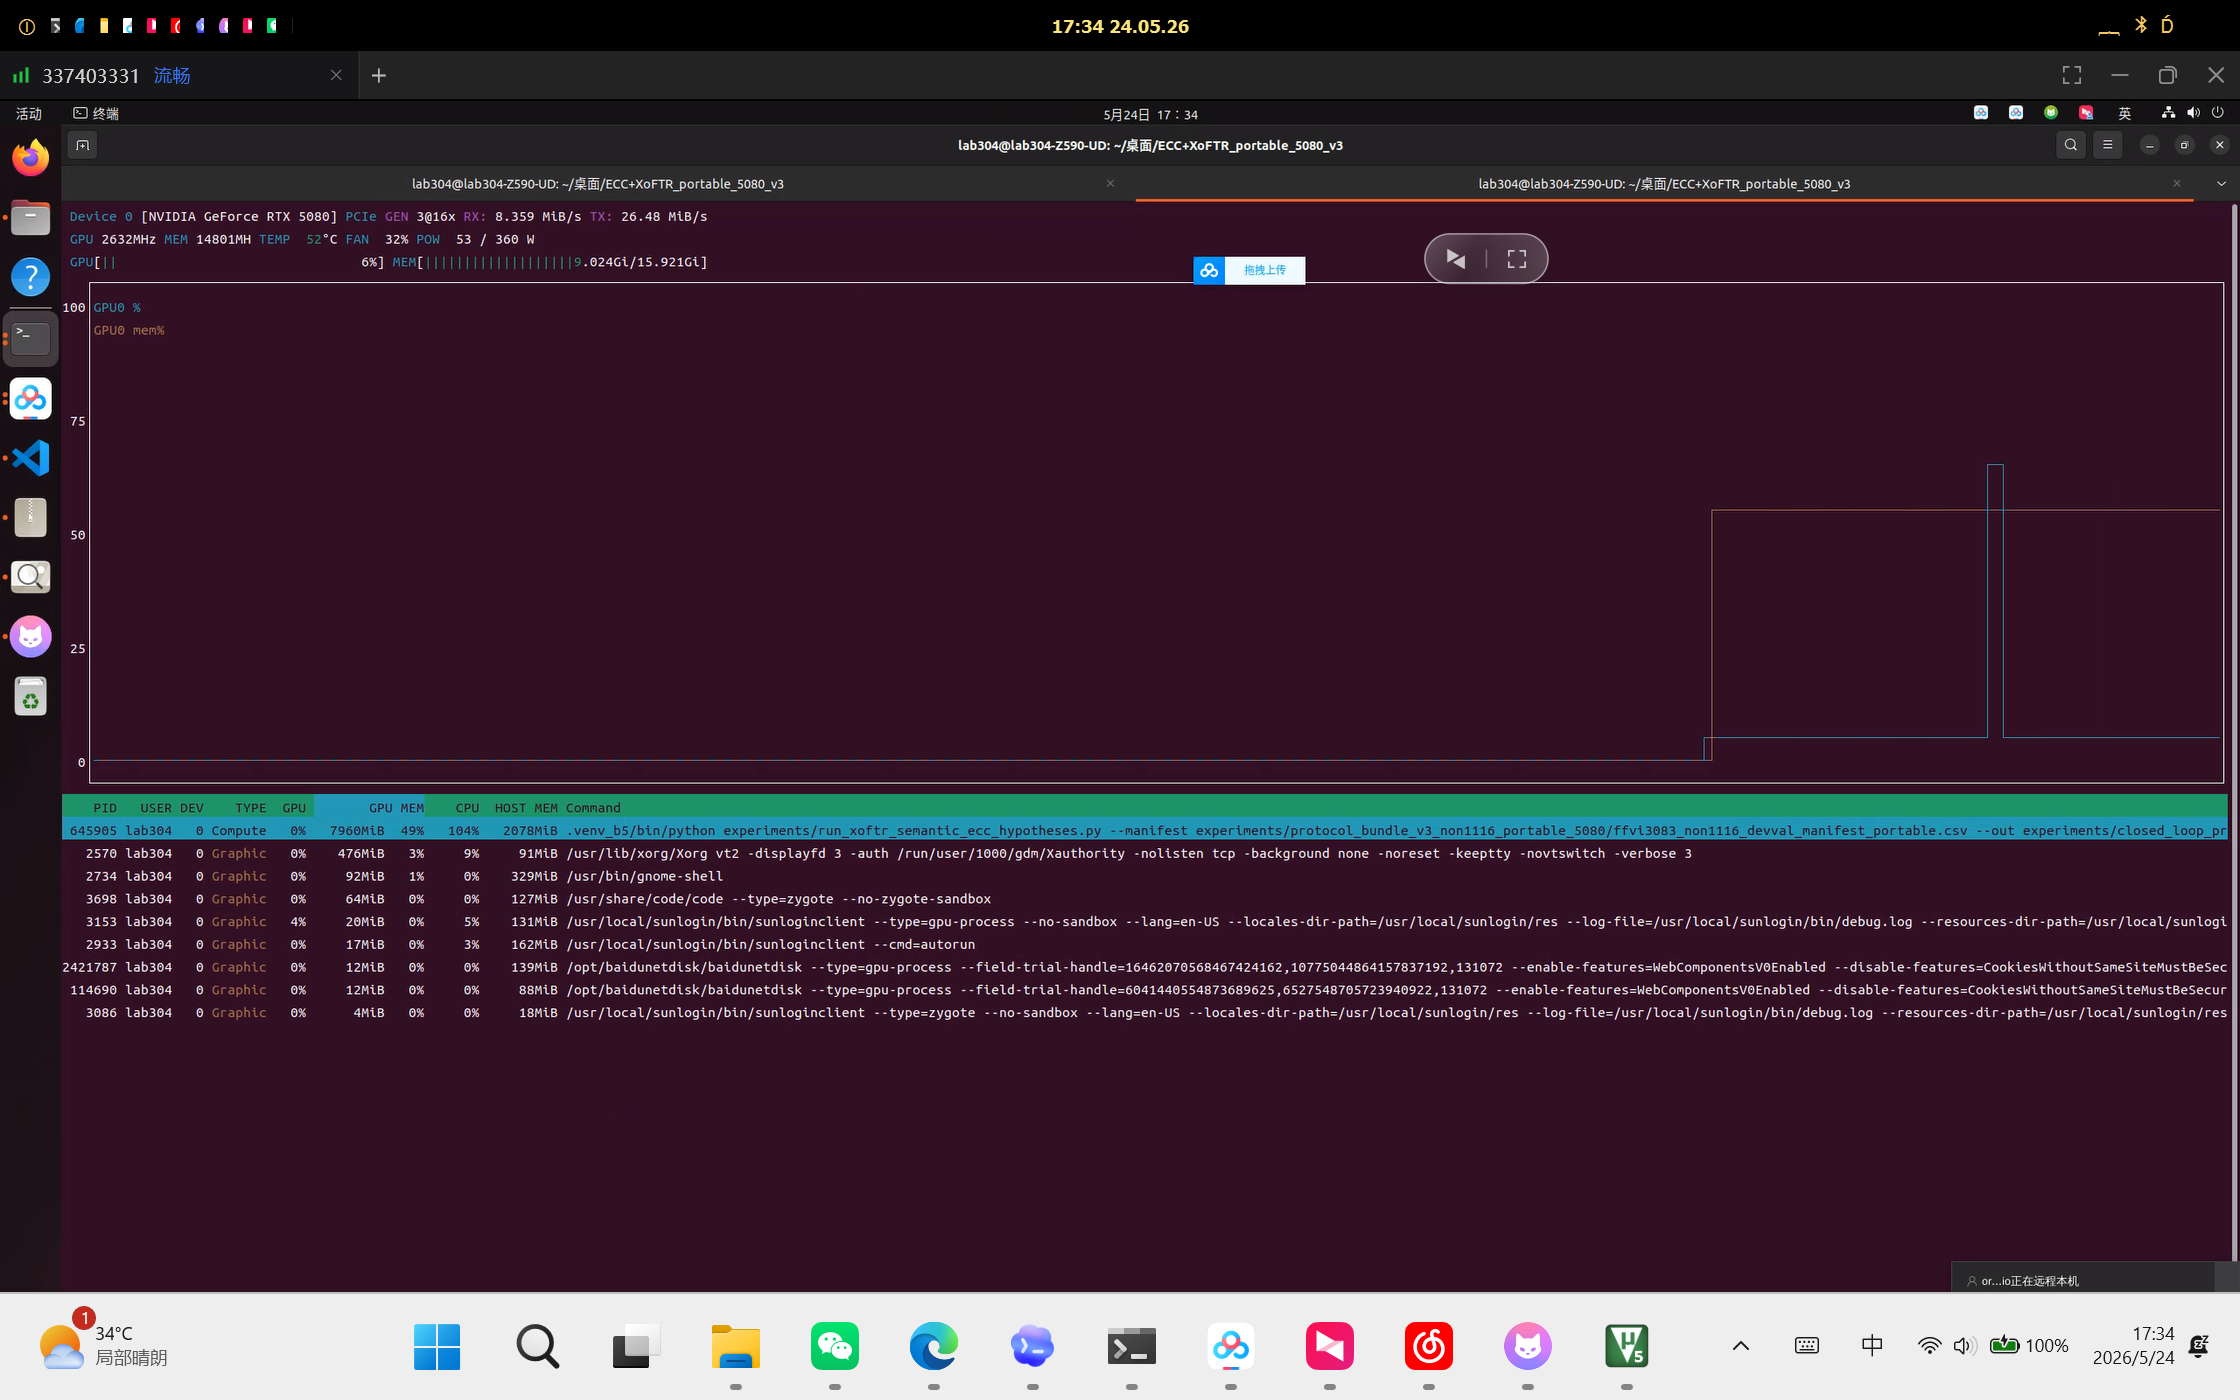
GPU 运行期间可用 nvtop 或 watch -n 1 nvidia-smi 观察显存、利用率和温度。环境检查只验证运行条件,不代表配准质量已经达标。
15.2 B5 闭环的耗时来源
这次运行的 B5_label_guided_semantic_residual_fusion 不是单次 XoFTR 配准,而是“粗配准—语义约束—残差修正—质量选择”的闭环。主要开销来自:
- 每对图像先运行 XoFTR 全局匹配,得到粗配准候选;
- 在候选附近进行局部残差搜索,枚举多个
dx/dy; - 对每个候选执行 warp、语义质量、黑边、方向合法性检查并排序;
- 保存 overlay、checkerboard、registered 等中间证据,产生额外 I/O。
因此日志中的 [13/1967] 表示正在处理完整 3083-non-1116 的第 13 对,总量是 1967 对,并不是只处理 100 对。目录名 b5_non1116_head100_v5 属于旧命名,不能据此判断当前 manifest 的规模。
15.3 记录的结论边界
- “GPU 吃算力”是该闭环包含全局匹配、残差搜索和多指标筛选的正常现象;不能仅凭 GPU 利用率判断算法是否正确。
- 处理进度、显存和 I/O 只说明运行状态;最终是否可用仍以 EdgeF1、Chamfer、MI、语义一致性和失败率等指标为准。
- 该阶段记录用于解释历史运行,不改变当前正式流程的尺寸、坐标和测试集口径。