配准实验与工程验证
本页把“实验结论”和“工程落地”放在同一条可复现链路中:先看性能/几何实验,再看真值驱动的坐标与裁剪,随后核对端侧量化,最后处理非对称视场融合。历史协议、正式协议和候选参数均已明确标注,不能跨实验口径混用。
1. 性能、选择器与几何评价
本页按时间顺序整理阶段性实验,但把“已经测得的事实”“当前解释”和“下一步计划”分开。数字只在对应数据集、分辨率和计时协议下成立;不要把开发集结果写成独立测试集结论。
1. 实验对象与评价口径
主要比较 XoFTR(当前 Ours)与 LoFTR,在相同 640×480 输入、相同样本清单和相同硬件环境下记录:
- 匹配数量与 RANSAC 内点;
- GNCC、MI 等连续指标;
- High/Middle/Low 质量等级;
- 矩阵成功数、ROI 有效数和异常纠正数;
- 推理时间、P95 和人工几何误差。
质量等级只是工程门控,不能替代独立 landmark 几何误差。后文的 20 对、200 对、36 对/237 点和 3083/3326 对属于不同实验口径,不能混用分母。
2. 200 对基准耗时
同一批 200 对、同为 640×480:
| 方法 | 中位数 | 均值 | T95 |
|---|---|---|---|
| XoFTR | 471.9 ms | 476.0 ms | 604.8 ms |
| LoFTR | 108.8 ms | 163.8 ms | 375.7 ms |
按中位数,XoFTR 约为 LoFTR 的 4.3 倍;按均值约为 2.9 倍。差异主要来自:
- XoFTR 平均约 3889 个匹配点,LoFTR 约 389 个,接近 10 倍;
- 当前 XoFTR 代码只使用
no_grad,尚未启用 FP16/AMP、torch.compile或 TensorRT; - 476 ms 只包含匹配、取点和仿射 RANSAC,不含读图、检测、候选生成、Warp、评价和保存。
因此当前 XoFTR 单路径约为 2.1 FPS。若每对只调用一次并使用 FP16、匹配点裁减和推理优化,完整流程仍有机会接近 1 秒;这只是工程目标,不是已验证结果。LoFTR 速度明显更快,而可用率只比 XoFTR 低约 1 个百分点,XoFTR 的潜在优势主要体现在 ROI 增益和跨模态稳定性,而不是速度。
3. 30 对同步 Profile
环境:RTX 3070 Ti,FP32,同步计时,预热 5 对。
3.1 阶段耗时
| 阶段 | 平均耗时 | 总耗时占比 |
|---|---|---|
| XoFTR 前向 | 234.88 ms | 84.5% |
| 仿射 RANSAC | 38.70 ms | 13.9% |
| 图像预处理与上卡 | 3.28 ms | 1.2% |
| 匹配点回传 | 0.65 ms | 0.2% |
| 其他 Python 开销 | 0.37 ms | 0.1% |
XoFTR 前向内部:
| 子阶段 | 平均耗时 | 占总时间 |
|---|---|---|
fine_process |
118.73 ms | 42.7% |
| backbone | 50.26 ms | 18.1% |
| coarse transformer | 36.34 ms | 13.1% |
| coarse matching | 20.80 ms | 7.5% |
| fine matching | 7.62 ms | 2.7% |
本次同步测得总耗时均值 277.88 ms、中位数 266.94 ms、P95 393.39 ms。同样 30 对的历史均值为 461.00 ms,且匹配点数量逐对完全一致,说明原来的 476 ms 还受到 GPU 频率、资源竞争或运行状态影响。
结论:瓶颈在 fine_process,不在预处理。下一步优先限制进入 fine_process 的匹配预算、测试 FP16/AMP、压缩 RANSAC,并用同一批样本同步比较指标和视觉结果。
详细结果:XoFTR耗时剖析.md;逐样本数据:per_pair_stage_times.csv。
4. 数据与实现材料
- XoFTR 权重:
E:\视觉\codex_v58_gatefix\codex_v58_gatefix\weights_xoftr_640.ckpt - XoFTR 源码:
E:\视觉\experiments\最终交付\rdks100_missing_mainline_patch_20260616\XoFTR - 最终 YOLO 权重:
E:\视觉\experiments\最终交付\rdks100_package_20260616\models\firefighter_detector_non1116_v1\best.pt - 统一 200 对清单:
C:\Users\12706\Desktop\FF-VIReg\小论文-大改\01_同协议200对_XoFTR_SIFT_SURF_ORB_NGF\sample_manifest.csv - 原始 VIS、IR 路径已写在清单中;
- GNCC、MI、ROI 指标和质量分级代码可以复用;
- coarse matching 后、
fine_process前是候选裁减的插入位置。
最终 YOLO 权重的类别顺序为:0=smoke、1=fire、2=firefighters。工程增强权重顺序不同,不能混用。现成自动 ROI JSON 只有 1116 对结果,当前 200 对仅覆盖 80 对;剩余 120 对不能用人工 LabelMe 标注替代,否则会把人工真值混入方法实验。需要用最终 YOLO 权重对 200 对统一重推理。
5. Top-K 预算曲线
第一阶段不使用 ROI 或 YOLO,只验证进入 fine_process 的候选数量是否造成冗余。配置为 All、2048、1536、1024、768、512、256,共 200 对 × 7 档 = 1400 组。
All 路径与原始 XoFTR 严格一致:
- 匹配点数:200/200 一致;
- RANSAC 内点数:200/200 一致;
- 质量等级:200/200 一致;
- 最终矩阵最大差:0。
| K | Fine process | 总耗时 | 相对 All 降幅 | High+Middle |
|---|---|---|---|---|
| All | 100.50 ms | 310.03 ms | — | 79.5% |
| 2048 | 58.55 ms | 228.24 ms | 26.4% | 78.0% |
| 1536 | 47.95 ms | 210.41 ms | 32.1% | 78.5% |
| 1024 | 35.51 ms | 178.29 ms | 42.5% | 76.0% |
| 768 | 32.00 ms | 176.68 ms | 43.0% | 76.5% |
| 512 | 26.87 ms | 164.22 ms | 47.0% | 77.0% |
| 256 | 27.90 ms | 166.86 ms | 46.2% | 77.0% |
结论:
fine_process随 K 显著下降,精匹配阶段存在 correspondence 冗余;- Top-K 同时压缩 RANSAC:All 为 68.53 ms,K=1536 为 16.36 ms,K=512 为 2.89 ms;
- K=512 后进入固定开销平台,降到 256 没有继续加速;
- 仅 confidence 排序会损失部分样本,也会救回少数样本。K=1536 总耗时下降 32.1%,High+Middle 仅下降 1 个百分点,配对差异不显著(McNemar
p=0.625)。
K=512 的 ROI-GNCC 提高但全局 MI 下降,说明剪枝改变了对应点的空间分布。完整结论见 TopK预算曲线结论.md,逐样本数据见 per_pair_results.csv,复现脚本为 run_xoftr_topk_budget_curve.py。
6. Cue 选择器与主配置
6.1 ROI 覆盖
200 对中:
- 174/200 对使用消防员 ROI;
- 12/200 对无消防员,使用火区 ROI;
- 14/200 对无有效任务 ROI,直接使用 Structural Cue;
- 不生成虚拟 ROI、不用烟雾替代、不引入人工标注。
候选级分析:
- Semantic Cue 全局区分能力较弱,AUC 约 0.52;
- Structural Cue 更稳定,AUC 从 K=1536 的 0.646 提升到 K=512 的 0.663。
因此无 ROI 时单独使用 Structural Cue 是合理的,不需要强行补语义区域。完整结论见 Cue有效性结论.md。
6.2 固定预算结果
主配置建议为 K=1024 Structural selector:
- High+Middle:76.0% → 79.0%;
- 相对 All 仅低 0.5 个百分点;
- 含 Structural map 后约 192.6 ms,相对 All 的 310.0 ms 下降约 37.9%;
- ROI-GNCC 提升显著,
p=0.017; - 等级净救回 6 对,但 McNemar
p=0.070,不能宣称等级显著提高。
K=512 OOF Focus 是强压缩点:
- High+Middle 为 78.0%;
- 全局与 ROI-GNCC 均显著改善;
- YOLO 共享时约 186.5 ms,全部独立计入约 256.1 ms;
- 视觉审查发现一例明显过尺度退化,因此不作为默认配置。
无任务 ROI 的 14 对在三档矩阵中均与 Structural 分支 14/14 一致。当前论文表述应为:Structural Cue 形成可靠主收益,Semantic 可提供任务区域预算倾斜,但不适合单独主导选择。相关材料:固定预算Cue选择器结论.md、数据驱动Focus结论.md。
7. 36 对 / 237 点几何验证
人工 landmark 只用于最终评价,没有参与调参:
| 配置 | RMSE≤5 px | RMSE≤10 px | RMSE≤20 px |
|---|---|---|---|
| All XoFTR | 7/36 | 18/36 | 33/36 |
| K=1024 confidence | 9/36 | 18/36 | 29/36 |
| K=1024 Structural | 9/36 | 19/36 | 32/36 |
| K=512 Focus | 12/36 | 24/36 | 29/36 |
K=1024 Structural 在 20 px 层面接近 All,并明显优于同预算 confidence-only,仍是默认可靠配置。K=512 Focus 产生更多 5–10 px 高精度结果,但 20 px 长尾更差,继续作为强压缩配置。
8. 3083 对全量与独立 ROI 协议
3083 全量 Ours 已完成:
- 3083/3083 均成功生成矩阵;
- High 28.15%、Middle 33.25%,合计 61.40%;
- 平均 174.50 ms,P95 约 320.45 ms。
200 对开发样本在这次全量中的 High+Middle 为 78.5%,与原 200 对的 79.0% 相差 0.5 个百分点,说明全量下降主要来自样本构成,而不是入口跑错。
独立 ROI 协议不是另画一套人工框,而是对自动检测多边形做固定棋盘格拆分:
A B A B
B A B A
A B A B
B A B A
- A 像素:只用于 candidate decision / quality selection;
- B 像素:完全不参与选择,只在矩阵冻结后用于 evaluation。
9. 460 对等级分歧
| 分歧组 | 数量 | 被判 Low 的方法 |
|---|---|---|
| 仅 Ours 达到 High/Middle | 197 | LoFTR |
| 仅 LoFTR 达到 High/Middle | 263 | Ours |
Middle-quality 的硬条件包括矩阵有效性、全局支持率、配准后全局 GNCC、配准后全局 MI、全局 GNCC/MI 相对增益,以及适用时的 ROI 支持率。ROI-GNCC 和 ROI-MI 不属于硬条件;失败原因采用多标签统计。
| 分歧组 | MI 条件任一失败 | GNCC 条件任一失败 | 支持率任一失败 | 仅 MI 家族失败 |
|---|---|---|---|---|
| 仅 Ours 可用(197) | 152(77.2%) | 89(45.2%) | 35(17.8%) | 90(45.7%) |
| 仅 LoFTR 可用(263) | 236(89.7%) | 175(66.5%) | 15(5.7%) | 84(31.9%) |
MI 是最常见的门控失败项,但 263 对中 Ours 的 Low-quality 不能归结为“只被 MI 卡掉”:66.5% 同时违反至少一项 GNCC 条件,仅由 MI 家族单独造成的只有 84 对。LoFTR 多出的 66 对 High/Middle 不能用单一 MI 偏置解释。
分歧子集的全局增益中位差:
- 仅 Ours 可用组:Ours−LoFTR 的 GNCC 为 +20.57 个百分点,MI 为 +16.18 个百分点;
- 仅 LoFTR 可用组:对应差值为 −53.22 和 −44.05 个百分点。
10. 当前协议下的几何对比
| 方法 | RMSE≤5 px | RMSE≤10 px | RMSE≤20 px | 中位 pair RMSE |
|---|---|---|---|---|
| LoFTR(当前 3083 冻结矩阵) | 9/36 | 17/36 | 28/36 | 10.87 px |
| K=1024 Structural(同一残差守卫) | 9/36 | 19/36 | 32/36 | 8.39 px |
| 前后端组合(探索性) | 12/36 | 19/36 | 35/36 | 7.93 px |
K=1024 Structural 与当前 LoFTR 的配对 pair-RMSE 中位差(Ours−LoFTR)为 −0.85 px,Wilcoxon 双侧 p=0.0425;单独阈值的 McNemar 检验未达到显著。
探索性前后端组合相对 LoFTR 的中位差为 −1.55 px,Wilcoxon 双侧 p=0.0183。在 RMSE≤20 px 阈值上,组合方法独有通过 7 对、LoFTR 独有通过 0 对,精确 McNemar p=0.0156;RMSE≤5 px 和 ≤10 px 差异尚不显著。
因此当前证据支持:
LoFTR 在既定 operational grade 下获得更高的 High+Middle 比例,而 Ours 主配置在人工几何误差上更低。
前后端组合仍属于 36 对上的探索性结果,不能代替独立测试集验证。3083 全量目录中的未守卫中间矩阵也不能直接当作组合方法最终配置。
11. 49 个异常样本的视觉审查
对“结构充分、LoFTR 可用、Ours 明显配歪”的 49 个样本审查发现:
- Ours 内点率中位数 2.48%,LoFTR 为 18.42%;
- Ours 仿射最大尺度中位数 5.02,平移中位数 1551 px;
- 49/49 仍覆盖四象限,选后凸包保留剪枝前的 99.15%,不支持“点被 Structural 裁到一侧”;
- 矩阵重新 Warp 与已有结果完全一致,未发现 compose 错误;
- 当前 All 结果只覆盖 3 对,3/3 同样失败,其余 46 对暂不能区分 backbone、fine 或 RANSAC;
- scene 3 的诊断性极端仿射比例达到 76.1%,但这是规则筛查比例,不等同于逐图确认失败率。
12. 当前主张与下一步
可以主张
- XoFTR 是该任务中更合适的跨模态 correspondence backbone;
- 全局梯度 Top-K 在固定预算下压缩 fine refinement;
- 同一梯度信息可在前端排序、后端估计全局小平移;
- ROI 不参与前端选择,仅通过匹配残差形成独立位置先验;
- 固定几何有效性检查阻止明显异常 affine 直接输出;
- 方法最终只输出一个全局变换矩阵。
暂时不能主张
- 20 对结果证明总体最优;
- Semantic Cue 主导 correspondence selection;
- ROI 对最终矩阵没有影响;
- 异常纠正机制等同于物理标定或数据驱动可靠性模型;
- 自动指标能够完全替代几何真值或视觉审查。
下一步
- 固定当前方法、指标与坐标协议,在正式 200 对公共视场上重跑 baseline、完整方法和四项消融;
- 用 36 对人工 landmark 报告 RMSE≤5、≤10、≤20 及分布;
- 扩展到 FF-VI3083,报告连续指标、失败数、运行时间和分序列视觉抽查;
- 配准结果冻结后,再单独评价融合和下游任务,不反向修改配准指标;
- 将 FP16、候选裁减和 RANSAC 优化与同一批指标绑定验证。
2. 真值驱动的裁剪框与矩阵换算
先统一矩阵方向和三个坐标系,再把 IR 有效区投影到 VIS 原图,最后用 18 组真值统计共同裁剪框。所有换算都应通过独立点回代验证,不能只凭公式或视觉效果判断。
“IR 上下各裁 16 像素”仍然作废,完整 IR 640×512 必须参与标定。当前正式流程见视觉配准统一主笔记的正式坐标协议:标定后先统一裁成 1218×975,再对 VIS/IR 共同裁取 1216×912 并等比例缩放为 640×480;精配准直接在 640×480 中只变换 IR,越界截断、空缺补黑,VIS 不变,最终输出 640×480且不做反算。本文旧 640×480 工具坐标仅可用于历史追溯。
目标
利用 18 组人工标注/人工配准结果,把旧的 640×480 工作画布坐标还原到传感器原始坐标,统计 IR 在 VIS 中的真实覆盖范围,最后固定一套可复用的裁剪参数。
最终得到:
- 原始坐标系下的配准矩阵;
- IR 有效区域在 VIS 原图上的投影范围;
- 固定的 VIS 裁剪框;
- 固定的 IR 有效区域和坐标变换参数。
0. 先统一坐标方向
下面统一使用列向量和齐次坐标:
x = [x, y, 1]^T
约定旧人工矩阵 H_manual 的方向为:
x_VIS_old = H_manual × x_IR_old
也就是:旧 IR 画布 → 旧 VIS 画布。如果你的矩阵实际是 VIS→IR,必须先求逆或改写公式,不能直接套用下面的换算链。
1. 明确三个坐标系
1.1 原始传感器坐标
- VIS:1920×1080;
- IR:640×512。
1.2 固定的 IR 有效坐标
当前数据必须完整保留 IR 640×512,不固定去掉上下各 16 像素,因此有效区域为:
x_IR ∈ [0, 640)
y_IR ∈ [0, 512)
统计覆盖范围时,使用 IR 有效区四个角点:
(0, 0)、(640, 0)、(640, 512)、(0, 512)
边界点是否使用 639、511,要与代码的像素坐标约定一致。不要一部分代码使用“像素中心”,另一部分使用“图像边界”。
1.3 旧标准化画布
这是人工工具使用的 640×480 画布,可能包含黑边、裁剪偏移或缩放。需要记录:
- 旧 VIS 到原始 VIS 的坐标变换;
- 旧 IR 到原始 IR 的坐标变换;
- 黑边和裁剪的偏移量;
- 横向和纵向缩放系数。
2. 把人工矩阵还原到原始坐标
设:
L_IR:原始 IR → 旧 IR 画布;L_VIS:原始 VIS → 旧 VIS 画布;H_manual:旧 IR 画布 → 旧 VIS 画布。
坐标关系为:
x_IR_old  = L_IR × x_IR_raw
x_VIS_old = H_manual × x_IR_old
x_VIS_raw  = inverse(L_VIS) × x_VIS_old
因此原始 IR → 原始 VIS 的矩阵为:
H_raw = inverse(L_VIS) × H_manual × L_IR
这条公式成立的前提是矩阵方向和 L 的定义与上面完全一致。实际写代码前,先拿一对已知点验证:
x_VIS_raw ≈ H_raw × x_IR_raw
齐次坐标归一化
如果矩阵输出点为 (x', y', w'),最终像素坐标为:
x = x' ÷ w'
y = y' ÷ w'
如果代码使用行向量、矩阵方向相反,或 L 定义成“旧坐标 → 原始坐标”,公式形式会改变。先写清楚每个矩阵的输入和输出,再决定乘法顺序。
3. 用每组 H_raw 投影 IR 有效区
对第 k 组数据:
- 读取
H_manual_k; - 计算
H_raw_k; - 将 IR 有效区四个角点投影到 VIS 原始坐标;
- 对四个投影点做齐次归一化;
- 保存投影四边形、外接框和重投影误差。
四个投影点记为:
Q_k = {q_k1, q_k2, q_k3, q_k4}
每组外接框记录:
x_min_k、x_max_k、y_min_k、y_max_k
建议保存成表格:
| sample | x_min | x_max | y_min | y_max | 重投影误差 | 备注 |
|---|---|---|---|---|---|---|
| 01 | ||||||
| … | ||||||
| 18 |
4. 统计稳定 VIS 裁剪框
先明确目标:
- 要保留所有样本共同可靠的重叠区域:取各组有效区域的交集;
- 要覆盖所有样本的全部投影范围:取并集,但裁剪框会更大;
- 少数样本若是异常姿态,应先排查,不要让离群值决定裁剪框。
对轴对齐外接框,共同区域的计算为:
x1 = max(x_min_1, x_min_2, …, x_min_18)
x2 = min(x_max_1, x_max_2, …, x_max_18)
y1 = max(y_min_1, y_min_2, …, y_min_18)
y2 = min(y_max_1, y_max_2, …, y_max_18)
候选 VIS 裁剪框为:
[x1, x2) × [y1, y2)
如果 x2 ≤ x1 或 y2 ≤ y1,说明样本之间没有共同的轴对齐区域,不能硬裁;应检查矩阵方向、坐标变换、FOV,或改用多边形 Mask。
实际工程中,先把 18 个投影四边形画出来,再决定使用严格交集、带安全余量的交集,还是剔除离群样本后的统计范围。
5. 确定裁剪框后的固定流水线
假设统计得到 VIS 原图裁剪框 (x1, y1, x2, y2):
VIS
原始 VIS 1920×1080
    → crop(x1, y1, x2, y2)
    → 等比例缩放到工作画布
裁剪后的主点:
cx_crop = cx_raw − x1
cy_crop = cy_raw − y1
若再缩放,横向和纵向系数为 sx、sy:
cx_work = sx × cx_crop
cy_work = sy × cy_crop
IR
原始 IR 640×512
    → 按标定映射到第一次 1218×975 画布
    → 与 VIS 共同裁取 (1,31,1216,912)
    → 等比例缩放为固定工作 IR 640×480
VIS 必须使用完全相同的第二裁剪与缩放。精配准直接在该 640×480 中只移动 IR;最终不反算。
6. 手动工具只能用 640×480 时
若手动工具只能加载 640×480:
- 在高分辨率 VIS 裁剪图上记录点坐标;
- 将 VIS 点按实际缩放系数换算到工具画布;
- 在由完整 IR 经统一几何链生成的 640×480 图上记录对应点;
- 在同一工作坐标系中计算
H_small; - 明确
H_small只能接收缩放后的 VIS 坐标; - 当前正式输出无需把精配准矩阵转换回原坐标系;坐标还原只用于审计;
- 用独立验证点检查误差,不能只看手动点本身的拟合误差。
若 VIS 裁剪图为 1440×1080,工作画布为 640×480,等比例系数为:
sx = 640 ÷ 1440 ≈ 0.4444
sy = 480 ÷ 1080 ≈ 0.4444
7. 验证与异常排查
- 18 组矩阵方向均为 IR → VIS,或已统一方向;
-
L_VIS、L_IR的输入输出定义一致; - IR 投影角点使用完整有效区
(0,0)、(640,0)、(640,512)、(0,512);旧的(0,16)到(640,496)只属于已作废的历史裁剪; - 每组投影四边形没有明显跳变;
- 交集裁剪框宽高为正,并且没有切掉目标区域;
- 离群样本已单独标记,而不是静默混入统计;
- 用未参与估计的点或图像验证误差;
- 裁剪偏移、缩放系数、内参和
H均已保存; - 新数据使用同一坐标定义和同一预处理流水线。
最终操作口诀
先统一坐标方向,再还原矩阵;先固定 IR 有效区,再投影统计;先验证裁剪框,再固化流水线。
3. 端侧量化与部署验收
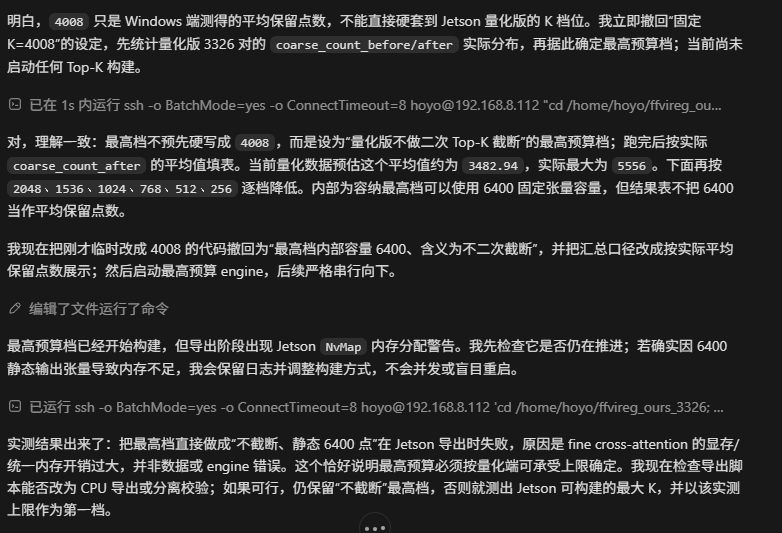
记录配准模型在 Jetson Orin NX 上的量化部署现状、已经拿到的数据和仍需补测的项目。不要把“可直接读取”误写成“已经完成正式实验”。
1. 当前部署口径
| 项目 | 当前口径 |
|---|---|
| 端侧板卡 | NVIDIA Jetson Orin NX Developer Kit,16 GB RAM |
| 输入规格 | 新流程生成的 VIS/IR,均为 640×480 |
| FP 模型 | PyTorch |
| 量化模型 | ONNX → TensorRT |
| 量化策略 | 任务校准 INT8,Backbone FP16 |
| 功耗模式 | Jetson MAXN;这是功耗模式,不等于实际瓦数 |
| 正式清单 | 当前为 3326 对;不能直接改名为 3189 对 |
所有 FP 与量化结果都必须使用同一份清单、同一预处理、同一坐标方向和同一评价脚本,才能进行公平比较。
2. 已可直接获取的材料
| 材料 | 当前状态 | 说明 |
|---|---|---|
| 板卡型号 | 可直接获取 | 系统可识别 Orin NX;SoC、CPU、GPU、DLA 和内存规格可由系统与官方资料整理 |
| 软件环境 | 可直接获取 | OS、Python、PyTorch、TensorRT、CUDA、cuDNN、OpenCV 可直接读取 |
| 模型部署形式 | 可直接获取 | FP 为 PyTorch;量化版为 ONNX→TensorRT,任务校准 INT8 + Backbone FP16 |
| 输入与预处理 | 可直接获取 | VIS/IR 均为新流程 640×480;裁剪框和 PC 侧清单已保留 |
| 部署流程 | 可直接获取 | 代码和 protocol 已完整记录,可整理为流程图 |
| 运行截图 | 可直接获取 | 实时处理时截取终端或显示屏 |
| FP 总处理时间 | 已有结果 | 3326 对 FP 已完成 |
| K=1024 量化总处理时间 | 已有结果 | 3326 对量化正式实验已完成 |
| 分阶段耗时 | 基本可获取 | 已记录预处理、XoFTR、后处理;RANSAC 当前包含在 XoFTR 阶段内 |
| 典型结果图 | 可直接获取 | FP 与 K=1024 量化各有 3326 张注册图及 overlay,可按场景筛选 |
| RAM 状态 | 可直接获取 | 可读取运行时快照,但一次快照不能称作峰值 |
3. 等七档实验完成的项目
当前七档正式实验仍在最高预算阶段,不能提前填正式结论:
| 项目 | 为什么要等待 |
|---|---|
| 七档总处理时间与 FPS | 需要所有档位跑完 |
| 七档分阶段耗时 | 需要完整逐对 CSV |
| 各档实际平均保留点数 | 最高预算档必须用完整 3326 对实测均值 |
| Top-K 耗时图 | 需要七档全部数据 |
| Top-K 匹配数、内点数和失败数 | 需要完整统计 |
| 各档相对最高预算的加速率 | 基准档与其他档必须同时完成 |
| Top-K 最终定量表 | 阶段性结果不能直接写进正式材料 |
4. 必须额外补采或补测
| 材料 | 补测方法 |
|---|---|
| 板卡实物照片 | 拍摄带电源灯、散热器、接线和运行画面的真实板卡 |
| 峰值运行显存/内存 | 推理期间持续运行 tegrastats 或同类监控 |
| 实际功耗(W) | 记录运行期间 VDD_IN、CPU_GPU_CV,或接外部功率计 |
| PC vs 端侧精度 | 用同一清单和流程取得 PC 结果,再与端侧逐对比较 |
| Grad-NCC、NMI、有效视场损失 | 从已有输出图和字段后处理,或对代表档补跑完整评价 |
| 3189 对独立检验集 | 先取得准确清单或明确从 3326 排除 137 对的规则 |
| 3189 对统计 | 确认是 3326 的固定子集还是另一套数据,不能直接改标题 |
| 完整硬件表 | 用 NVIDIA 官方规格补齐 CPU/GPU/DLA 核心等信息 |
5. 推荐的公平比较表
正式报告至少应包含:
| 方法 | 精度指标 | 成功/失败数 | 平均时间 | P95 时间 | 峰值内存 | 实际功耗 |
|---|---|---|---|---|---|---|
| FP | 待填 | 待填 | 已有 | 已有/待核对 | 待补测 | 待补测 |
| INT8 + FP16 | 待填 | 待填 | 已有 | 待核对 | 待补测 | 待补测 |
| Top-K 各档 | 待填 | 待填 | 待实验 | 待实验 | 待补测 | 待补测 |
精度不能只看总耗时;至少同时报告 GNCC、MI、矩阵成功数、内点率、有效视场和独立几何误差。
6. 当前结论与下一步
- FP 与 K=1024 量化的 3326 对正式运行已经完成,但端侧硬件功耗、峰值内存和 PC 对照仍不完整;
- 七档 Top-K 实验完成后,才能确定预算—速度—精度曲线;
- “3189 对”是当前最大的统计口径风险,必须先确认清单和排除规则;
- 论文中应把“已完成”“可直接读取”“待补测”分开列出,避免把估计值写成实测值。
先统一数据口径,再比较量化收益;先补齐功耗、峰值内存和 PC 基线,再给出部署结论。
4. 非对称视场融合与羽化
这篇只讨论“配准后的 VIS/IR 如何在非对称视场下融合”。输入是已经 Warp 到 VIS 坐标系的 IR、VIS 和有效区域 Mask;输出是保留真实信息、边界平滑的融合图。羽化不能修复错误配准,也不能为 IR 没有覆盖的区域生成信息。
1. 当前融合策略
当 IR 的视场小于 VIS 时,两者并不是在整幅画面上都有有效数据。推荐把画面分成两类区域:
- IR 有效区:有真实的 VIS 与 IR 信息,可以进行配准后的融合;
- VIS 独享区:IR 物理上没有覆盖,只保留真实 VIS,不用黑色、零值或虚构的 IR 信息填充。
这叫做非对称视场融合。它的基本原则是:
只在 IR 真正覆盖的区域使用 IR;IR 看不到的边缘区域由 VIS 独立呈现。
这样既不会伪造红外信息,也能避免融合结果出现死黑边。
2. 为什么羽化后边界仍可能看见
羽化只能平滑两种图像的权重变化,不能消除传感器本身的模态差异。边界隐约可见通常来自以下原因:
2.1 纹理密度不同
VIS 具有丰富的反射纹理、阴影和细小边缘;IR 的热辐射图像往往更平滑。即使像素值连续过渡,纹理从“丰富”突然变成“平滑”,人眼仍然能察觉。
2.2 亮度和对比度不同
IR 与 VIS 的灰度均值、对比度和动态范围通常不同。简单线性羽化为
如果两者在过渡区域的亮度差异很大,\(\alpha\) 虽然连续,融合结果仍可能出现亮度带或断层。
2.3 几何残差和插值边界
Warp 后的 IR 边缘可能包含插值空洞、黑色填充值或不完整像素。如果直接对这部分做羽化,会把“插值伪影”和真实 VIS 混在一起,形成一圈重影或暗边。
3. 推荐的融合流水线
IR 原图
  ↓ 配准 / Warp 到 VIS 坐标系
得到 IR_warp 与有效区域 Mask
  ↓ 腐蚀 Mask,去掉插值边界
得到可靠 IR 区域
  ↓ 亮度/对比度匹配(可选)
得到 IR_adjusted
  ↓ 生成羽化 Alpha
  ↓ Alpha 融合
IR 有效区:IR + VIS
VIS 独享区:保留 VIS
每一步的职责不同:Warp 负责几何对齐,Mask 负责区分真实覆盖与空洞,亮度匹配负责减少模态差异,Alpha 只负责在可靠区域之间平滑过渡。不要用一个步骤替代另一个步骤。
4. Mask 的处理顺序
4.1 先生成有效区域
Mask 应表示“Warp 后确实有真实 IR 像素”的区域,而不是简单把目标画布内的某个矩形全部设为 1。
4.2 对 Mask 腐蚀
建议在生成羽化权重前,对有效 Mask 做少量腐蚀,例如 \(2\)~\(3\) 个像素:
kernel = np.ones((3, 3), np.uint8)
mask_safe = cv2.erode(mask_valid, kernel, iterations=1)
腐蚀的目的不是缩小真实 FOV,而是排除 Warp 边界处的插值不稳定像素。腐蚀半径应根据 Warp 插值方式、分辨率和实际边缘质量验证,不能盲目设得很大。
4.3 再生成羽化权重
可以根据到 Mask 边界的距离生成 Alpha:
其中 \(D\) 是距离变换。Mask 中心区域的 \(\alpha\) 接近 \(1\),边界逐渐降到 \(0\)。
最终融合:
在 VIS 独享区,直接令 \(\alpha=0\),保留 VIS 原图。
必须先用有效 Mask 排除 Warp 空洞,再腐蚀 Mask,最后生成 Alpha。顺序反过来可能造成黑边、暗圈或半透明重影。
5. 亮度与对比度匹配
如果 IR 和 VIS 在对应有效区域内存在明显亮度差,可以在融合前对 IR 做仿射标准化:
其中:
- \(\mu_{IR}\)、\(\sigma_{IR}\):IR 有效区域的均值和标准差;
- \(\mu_{VIS}\)、\(\sigma_{VIS}\):对应 VIS 区域的均值和标准差。
计算时只使用有效重叠区域,不要把黑边或无效 Mask 区域统计进去。最后要进行裁剪和类型转换,例如限制到 \([0,255]\)。
这一步严格来说是均值-方差亮度/对比度匹配,不等同于严格意义上的伽马校正。若场景亮度变化很大,固定的全局均值可能不够,还需要分块、局部或时序稳定化。
6. 边界仍明显时的排查顺序
- 检查 IR Warp 是否有黑色插值边界;
- 检查有效 Mask 是否准确;
- 对 Mask 做少量腐蚀,再重新生成 Alpha;
- 检查融合前两幅图像是否存在明显亮度/对比度差;
- 检查配准误差,尤其是过渡带附近的直线和角点;
- 适当增大羽化宽度,但不要用过宽羽化掩盖几何错位;
- 若仍有纹理突变,再考虑多频段融合,而不是继续简单调 Alpha。
7. 多频段融合:后续优化方向
简单羽化只是在像素值层面做加权,适合当前 Baseline。若需要进一步降低纹理突变,可使用 Laplacian pyramid 等多频段融合:
- 低频部分缓慢过渡亮度和颜色;
- 高频部分保留各自更可靠的局部细节;
- 过渡带不再对所有频率使用同一个 Alpha。
但多频段融合不能修复错误配准,也不能凭空产生 IR 信息。几何配准、有效 Mask 和亮度匹配仍然是前置条件。
8. 当前 Baseline 参数记录
建议把以下参数与输出结果一起保存:
- 配准矩阵 \(H\);
- Warp 输出尺寸;
- 有效区域 Mask;
- Mask 腐蚀核大小和迭代次数;
- 羽化宽度或距离变换参数;
- \(\mu_{IR},\sigma_{IR},\mu_{VIS},\sigma_{VIS}\);
- 融合权重定义和颜色/灰度范围。
最终结论
当前“IR 有效区融合 + VIS 独享区保留 + Mask 腐蚀 + 羽化”的方案,是一个合理、可解释、适合作为基线的工程方案。边界是否完全不可见,不只取决于羽化,还取决于几何误差、插值质量、模态纹理差异和亮度匹配效果。
先保证真实信息和有效 Mask,再做羽化;先解决亮度差异,再考虑更复杂的多频段融合。
5. 跨阶段验收清单
- 正式实验使用统一公共视场:完整 IR 参与标定,VIS/IR/Mask 按固定坐标链生成 640×480;
- 20 对历史诊断只用于实现核查,不用于替代正式 200 对或 FF-VI3083 结论;
- 矩阵方向、裁剪偏移、缩放系数和 IR 有效角点均已保存;
- 速度、精度、内存和功耗分开测量,并注明数据集与硬件;
- 量化与 FP 使用同一清单、预处理、坐标方向和评价脚本;
- Warp 后先建立有效 Mask,再腐蚀、亮度匹配和生成 Alpha;
- 融合不向 VIS 独享区填充虚构 IR 信息;
- 以独立 landmark、支持率和视觉抽查共同判定结果。
先冻结坐标和评价协议,再比较方法;先保证真实支持区域,再做融合和端侧优化。