comfy
概述与目标
本页是一条 ComfyUI 入门与长期练习路线:先跑通最小工作流,再逐层理解提示词、采样参数、模型、LoRA 和插件。它记录图像生成工作流的通用方法,不把某一个 checkpoint 或一次出图结果写成稳定结论。
参考资料
https://laowang.vip/search/s.php?q=comfy
原记录曾在该站点参考教程;以下链接仅作资料入口,具体步骤以本页可复现流程为准。
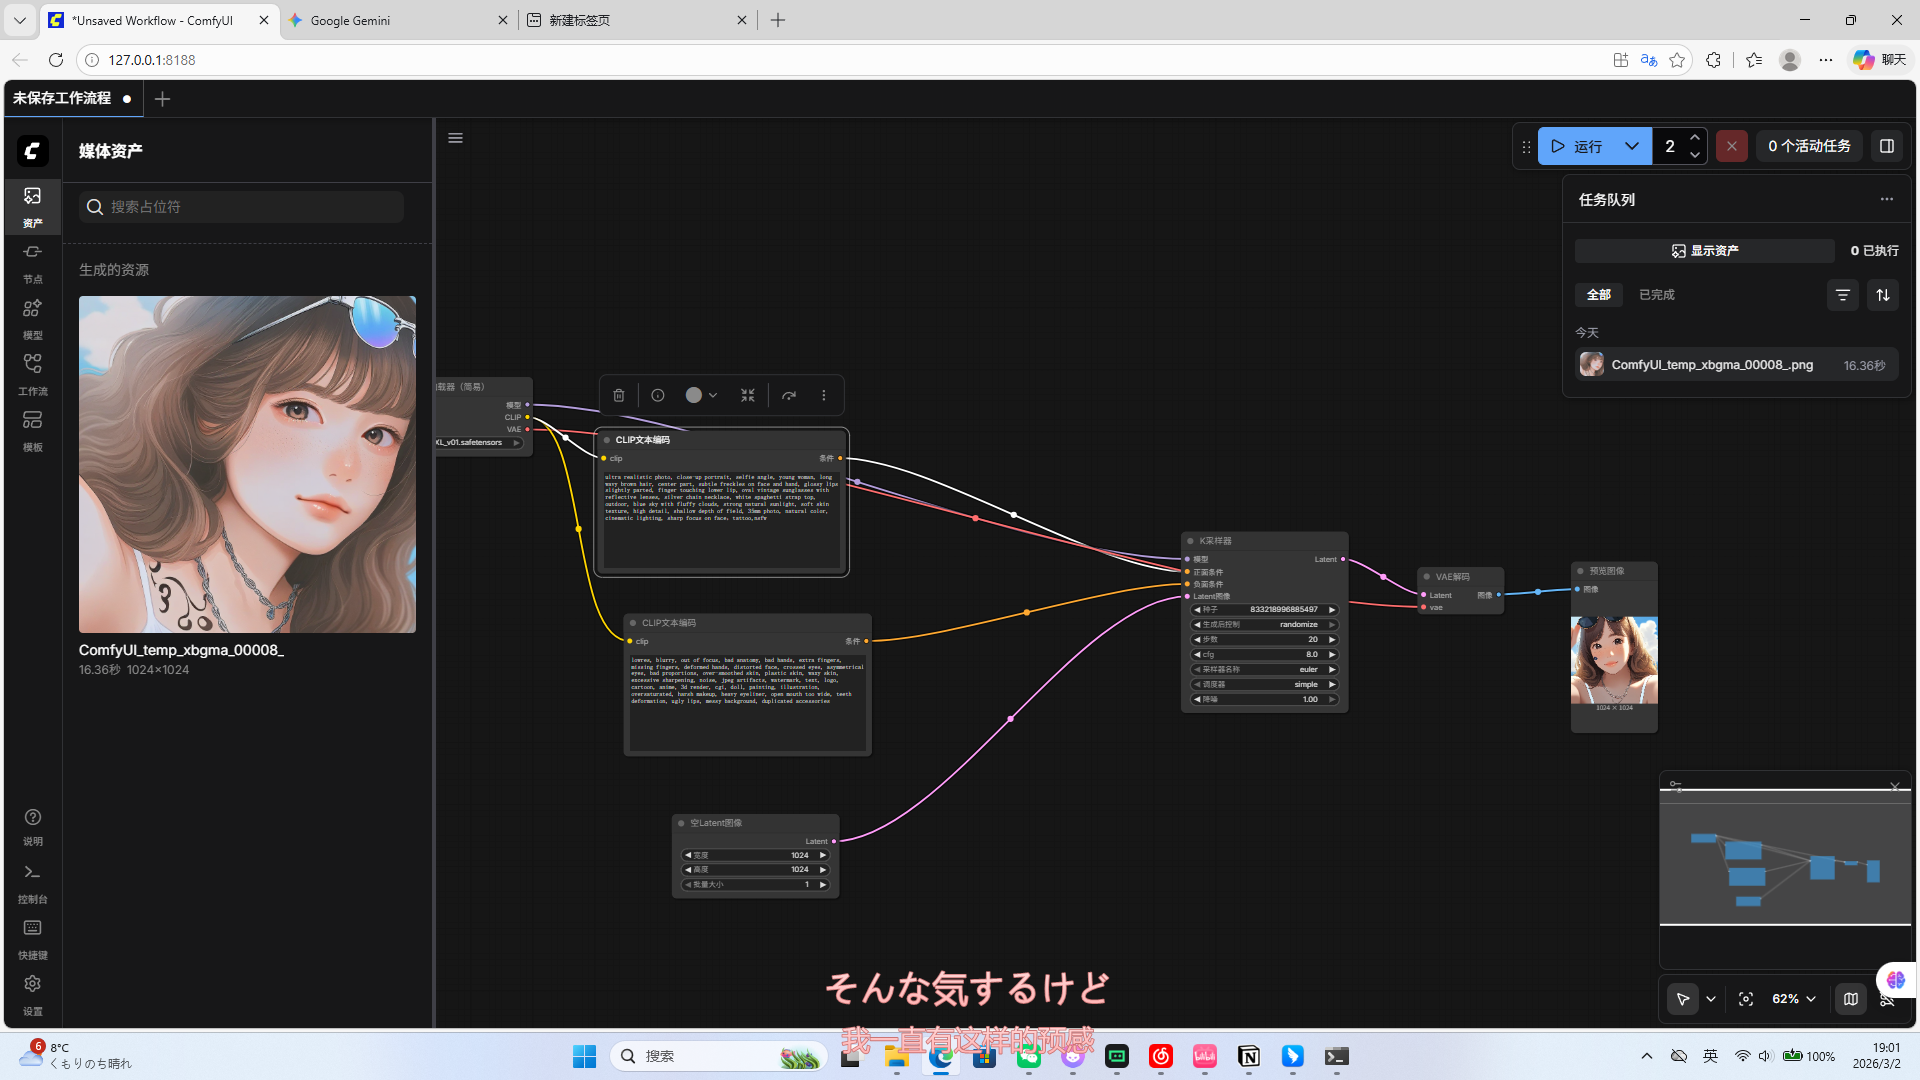
成功了!
读法建议:先把「最小工作流」跑通,再按路线逐步扩展。遇到报错时,直接跳到「排错思维」。
1. 建立正确认知:ComfyUI 是什么
ComfyUI 不是“一个模型”,而是把 AI 出图流程可视化、节点化的工作流工具。
你可以把一次出图理解成一条流水线:
- 加载模型 → 输入提示词 → 创建 latent → 采样生成 → VAE 解码 → 输出图像
ComfyUI 把这些步骤都摊开给你看。结果是:
- 一开始会觉得麻烦
- 一旦理解,就更容易进阶到 LoRA、ControlNet、局部重绘、高清放大、批量化与自动化
2. 学习路线总览(按阶段)
- 阶段 1:跑通最小工作流
- 会安装、会放模型、会出第一张图
- 阶段 2:提示词与参数
- 知道为什么好看或不好看
- 阶段 3:模型 / LoRA / 工作流导入
- 能复现别人的图,也能在 workflow 上改
- 阶段 4:插件与扩展节点
- 开始用 Manager,安装常用自定义节点
- 阶段 5:修图与提质
- img2img、局部重绘、放大、修脸
- 阶段 6:进阶工程化
- 批量生成、参数管理、复杂工作流搭建
3. 安装前准备
最重要的是显卡,优先 NVIDIA。体验主要看显存:
- 8GB:可入门,容易卡显存
- 12GB:比较舒服
- 16GB+:进阶更稳
内存建议至少 16GB,32GB 更合适。硬盘建议预留几十 GB 起步,模型会越来越多。
更推荐优先学 SDXL(如果显卡扛得住)。
- SD1.5:轻、老、资源多、门槛低
- SDXL:新、质量更高、理解提示词更好、显存要求更高
4. 安装 ComfyUI(Windows 新手推荐)
推荐 portable 便携版:自带 Python 环境,依赖少,出问题也方便整体替换。
放到英文路径,尽量不要有空格或中文,例如:
-
D:\ComfyUI\ -
ComfyUI\models\checkpoints:主模型(checkpoint) -
ComfyUI\models\loras:LoRA -
ComfyUI\models\vae:独立 VAE -
ComfyUI\output:默认输出 -
python_embeded:自带 Python 环境(不要乱删)
5. 第一次启动
启动时运行对应显卡的 .bat。第一次启动慢很正常,会下载依赖。
正常情况:命令行窗口启动 + 自动打开浏览器进入 ComfyUI 页面。没弹出就手动访问本地地址。
6. 第一张图:最小可运行工作流(一定先跑通)
- Load Checkpoint(加载模型)
- CLIP Text Encode(Positive)(正面提示词)
- CLIP Text Encode(Negative)(负面提示词)
- Empty Latent Image(空 latent)
- KSampler(采样器)
- VAE Decode(解码)
- Preview Image / Save Image(预览或保存)
-
Load Checkpoint:输出
model / clip / vae -
CLIP Text Encode:把提示词编码成模型能理解的向量
-
Empty Latent Image:决定要画多大的“潜空间画布”
-
KSampler:把噪声逐步采样成图像结构(出图核心)
-
VAE Decode:把 latent 解码成人眼可见图
-
Preview / Save:显示或保存结果
-
Checkpoint 的 model → KSampler 的 model
-
Checkpoint 的 clip → Positive Text Encode 的 clip
-
Checkpoint 的 clip → Negative Text Encode 的 clip
-
Positive Text Encode 输出 → KSampler 的 positive
-
Negative Text Encode 输出 → KSampler 的 negative
-
Empty Latent → KSampler 的 latent_image
-
Checkpoint 的 vae → VAE Decode 的 vae
-
KSampler 输出 → VAE Decode 的 samples
-
VAE Decode 输出 → Preview / Save Image
7. 第一套推荐默认参数(先稳定,不追极限)
-
分辨率:1024 × 1024
-
Steps:24
-
CFG:5.5
-
Seed:随机
-
Sampler / Scheduler:先用默认或常见组合
-
分辨率:512 × 512 或 768 × 512
-
Steps:约 20
-
CFG:6 到 8 先试
8. 提示词入门:怎么写才不乱
按这个顺序写更稳定:
- 主体 + 外观 + 动作/姿势 + 场景 + 光线 + 风格 + 质量词
示例:
-
主体:
1girl, young woman -
外观:
long hair, white dress -
动作:
standing, looking at viewer -
场景:
garden, sunlight -
风格:
cinematic, detailed -
质量词:
masterpiece, best quality -
low quality -
bad anatomy -
extra fingers -
blurry -
distorted face
不要追“神 prompt”。先做到:
- 能控制主体是谁
- 能控制构图方向
- 能减少明显错误
- 能通过增删词观察变化
9. KSampler 参数详解(从会用到懂用)
- Seed:随机起点
- 固定:更容易复现
- 随机:更适合探索
- Steps:采样步数
- 20 ~ 30 最常用,新手从 24 稳
- CFG:提示词遵从度
- 太高:容易僵硬、翻车
- 太低:容易偏题
- 入门值:5.5 左右
- 分辨率:要符合模型“舒适尺寸”
- SD1.5 更适合 512 左右起步
- SDXL 更适合 1024 左右起步
核心方法:先在舒适尺寸出结构正确的图,再放大。
10. 模型体系速览(你迟早会遇到)
- Checkpoint:主模型,决定整体能力与风格
- LoRA:附加偏向(角色、画风、服装、表情、摄影感等),不能脱离底模单独用
- VAE:决定解码效果,多数情况先用模型自带
- Embedding / Textual Inversion:文本向量扩展,新手可先不碰
11. LoRA 正确入门方式
新手常见错误:不看底模兼容、一次堆太多、权重乱拉。
建议做法:
- 先确认 LoRA 属于 SD1.5 还是 SDXL
- 一次只上 1 个 LoRA
- 权重从低到高试:0.6 → 0.8 → 1.0
- 每轮只改一个变量:LoRA 或权重 或提示词
12. 工作流保存、导入、复用
- 先保存自己的 workflow:流程比提示词更重要
- 常见分享形式:workflow JSON、带元信息图片、截图
- 导入后报错通常是环境不完整:
- 缺模型
- 缺 LoRA
- 缺自定义节点
- 节点版本不一致
13. ComfyUI Manager(几乎必装)
作用:
- 管理自定义节点
- 补装缺失插件
- 更新插件
- 降低手动安装扩展的混乱
导入别人 workflow 时提示“某某节点不存在”,大概率就是没装对应节点包,优先用 Manager 处理。
14. 三类常见出图模式
- Text to Image:提示词 + 模型 + 采样
- Image to Image:基于现有图重做(改风格、改细节、保留构图)
- Inpaint 局部重绘:只改局部(修手、修脸、改衣服、换背景一块、加道具)
建议:学会 text2img 后,优先学 inpaint。
15. 为什么不该一开始追高分辨率
- 模型有舒适分辨率,偏离太多容易崩
- 分辨率越大越吃显存
- 大图不等于好图
正确流程通常是:
- 先出结构正确的图 → 再放大 → 再局部修
16. 放大与提质:标准思路
- 路线 1:纯放大:简单,细节补得有限
- 路线 2:放大后重绘:效果更好,流程更复杂
- 路线 3:局部重绘修关键区域:手、脸、眼睛、嘴、衣服边缘、饰品、背景文字
高质量图片通常是多轮迭代出来的,不是一次算完。
17. 排错思维(遇到问题先归类)
- 模型没识别:路径、目录、格式、是否重启/刷新
- 显存爆了:降分辨率、降 batch、减少复杂节点、减少 LoRA、换轻量模型
- 缺节点:没装扩展,优先用 Manager
- 图总变形:分辨率是否夸张、CFG 是否过高、Steps 是否不合理、提示词是否冲突、LoRA 是否堆太多
- 换模型后效果全变:正常,不同 checkpoint 的词汇理解和最佳参数都不同
18. 新手常见误区清单
- 提示词越长越好:不对,越长越容易互相冲突
- CFG 越高越好:不对,太高容易僵硬
- 步数越高越细:不对,可能适得其反
- 分辨率越大越高级:不对,先把结构做对
- workflow 导不进就是对方问题:不对,通常是你环境缺东西
- 一上来收集几百个模型:不对,先少量、明确用途
19. 7 天游泳式训练法(照着练最有效)
- 第 1 天:跑通最小工作流(目标:出第一张图)
- 第 2 天:只练提示词(固定模型与参数)
- 第 3 天:只练参数(seed / steps / cfg / 分辨率)
- 第 4 天:只练模型对比(同一组词换 3 个模型)
- 第 5 天:第一次加 LoRA(一次 1 个,练权重)
- 第 6 天:导入别人的 workflow(练“缺什么补什么”)
- 第 7 天:学局部重绘(从修脸或修手开始)
20. 进阶阶段:你最终会学到什么
- 多模型混用
- 多 LoRA 组合
- ControlNet 控制姿势/结构
- 遮罩与分区重绘
- 高清修复链路
- 角色一致性流程
- 批量生成、参数自动化
- 视频与动画工作流
- API 化与自动化调用
一句话:ComfyUI 更像“图像生成工作流引擎”,不只是出图软件。
21. 给你的实操版标准入门方案(可直接照做)
- 安装 ComfyUI portable。
- 下载一个确定兼容的 SDXL checkpoint,放进
checkpoints。 - 搭建最小工作流(Load Checkpoint → 两个 Text Encode → Empty Latent → KSampler → VAE Decode → Save/Preview)。
- 参数先固定:1024×1024、Steps 24、CFG 5.5、Seed 随机。
- 正面词先写:主体、外观、场景、风格;负面词只写常见问题项。
- 连续跑 10 张图,不要急着换工作流,先观察差异。
- 保存第一套“稳定出图”的 workflow,以后所有学习都在这套上迭代。
22. 长期方法论:每次出图按层定位问题
- 我用什么模型(先决定底模)。
- 我想要什么主体和风格(再写提示词)。
- 要不要加 LoRA(明确偏向)。
- 这次目标是探索还是稳定复现(决定 seed 等策略)。
- 图的问题在哪里(主体 / 构图 / 细节 / 局部翻车)。
- 我该改哪一层。
- 主体不对:改提示词
- 风格不对:换模型 / LoRA
- 随机性不对:改 seed
- 听话程度不对:改 CFG
- 细节不对:改 steps 或后期修
- 局部翻车:局部重绘
结论:先学会“最小主链”,再学提示词和参数,然后学模型与 LoRA,最后进阶到插件、重绘、放大和复杂工作流。
(可选)下一步内容选项
- A.《ComfyUI 新手标准工作流图解版》:把每个节点、连线、关键参数用更直白方式讲清楚
- B.《ComfyUI 进阶工作流大全》:文生图 / 图生图 / 局部重绘 / 放大修脸 / LoRA / ControlNet 分别拆开讲
验证与边界
最小工作流至少应能稳定生成一张图,并在固定模型、参数和 seed 后复现同一结果。出现报错时按“节点缺失 → 模型路径 → 显存/分辨率 → 参数 → 自定义插件”顺序排查;插件、模型和工作流版本要一起记录。高分辨率、视频和批量自动化属于进阶场景,不能用一次成功出图代替长期稳定性验证。
总结
ComfyUI 的核心是可观察、可复用的节点工作流。先固定最小主链,再一次只改变一个变量,最后将稳定工作流保存为基线;这样才能把出图体验转化为可解释、可回归的工程方法。